Jak zpracovávat data pomocí AI, aby nesloužila k trénování modelu a neopustila EU
Zákaz trénování a datová rezidence v EU jsou dvě různé věci. Jak je ověřit a nastavit na Google Cloud, AWS Bedrock a Azure OpenAI.
Nezávislý IT konzultant, 2× PRINCE2
Ve zkratce
- „Netrénuje se na datech“ a „data neopustí EU“ vyžadují dvě samostatná ověření.
- Rozhoduje konkrétní edice, region, model a zapnuté funkce – ne značka cloudu.
- Zkontrolujte celou cestu dat včetně vyhledávání, logů, záloh a konektorů.
Aktuálnost článku: Informace a odkazy byly ověřeny 8. září 2026. Nabídka modelů, regionální dostupnost a podmínky funkcí se mění. Před produkčním nasazením proto vždy zkontrolujte dokumentaci konkrétního modelu a funkce, kterou chcete použít.
Dvě otázky, které se často chybně spojují
Firma chce využít AI nad smlouvami, nabídkami, interními postupy nebo zákaznickými požadavky. První obava obvykle zní: „Nebude se na našich datech model učit?“ Hned za ní následuje druhá: „Neodejdou data mimo Evropskou unii?“
Tyto otázky spolu souvisejí, ale neznamenají totéž.
- Zákaz trénování určuje, zda poskytovatel smí použít vaše vstupy, výstupy a další zákaznická data ke zlepšování svých sdílených modelů.
- Datová rezidence určuje, kde se data ukládají a kde probíhá samotné strojové zpracování.
- Retence určuje, zda se kopie vstupu nebo výstupu po vyřízení požadavku uchová a na jak dlouho.
- Přístup k datům určuje, kdo se k nim může dostat, například administrátor, pracovník podpory nebo připojená externí služba.
Služba může slíbit, že data nepoužije k trénování, a přesto je zpracovat ve Spojených státech. Stejně tak může zpracovat požadavek ve Frankfurtu, ale ponechat jeho kopii v bezpečnostním logu. Aplikace může mít správně nastavený model, ale odeslat dokument do globálního vyhledávače, překladače nebo monitorovacího nástroje.
Proto nestačí koupit „enterprise AI“ a zaškrtnout evropský region. Je potřeba prověřit celou cestu dokumentu od zdrojového úložiště přes vyhledávání a model až po logy, zálohy a výsledek.
Nejdůležitější pravidlo: tvrzení „data se nepoužijí k trénování“ a „data neopustí EU“ vyžadují dvě samostatná ověření. Ani jedno automaticky nedokazuje druhé.
Co v tomto článku znamená „neopustit EU“
Pro praktický návrh budeme používat přísný výklad: obsah dokumentů, prompty, odpovědi, vyhledávací indexy, embeddingy a jejich případné bezpečnostní kopie se mají ukládat a strojově zpracovávat pouze v členských státech Evropské unie.
To je přísnější požadavek než samotné GDPR. GDPR nezakazuje každý přenos osobních údajů mimo EU. Stanovuje podmínky, za kterých může proběhnout. Naopak pouhé uložení dat v EU ještě nezaručuje soulad s GDPR. Stále potřebujete právní titul, správnou dobu uchování, řízení přístupů, smlouvu o zpracování a další opatření podle konkrétního účelu.
Pozor také na zeměpisné názvy cloudových regionů. AWS používá pro regiony v Londýně a Curychu označení začínající eu-, přestože Spojené království ani Švýcarsko nejsou členy EU. Slovo „Europe“ v názvu datacentra proto není právní hranice Evropské unie.
Tento článek popisuje technický a organizační základ. Nenahrazuje právní posouzení, posouzení vlivu na ochranu osobních údajů ani kontrolu smluv vaším pověřencem nebo právníkem.
Jaké řešení budeme porovnávat
Na Google Cloud použijeme Gemini Enterprise Agent Platform. Na AWS použijeme Amazon Bedrock. V obou případech jde o podnikové cloudové služby, ne o běžný veřejný chat otevřený v osobním účtu zaměstnance.
Vedle nich existuje ještě třetí cesta – Microsoft Azure OpenAI Service – která zpřístupňuje modely OpenAI (GPT-4o, GPT-4 a další) s garancí EU datové rezidence. Podrobný přehled modelů napříč všemi třemi platformami najdete v následující kapitole.
| Otázka | Google Cloud | AWS |
|---|---|---|
| Podniková AI služba | Gemini Enterprise Agent Platform | Amazon Bedrock |
| Použití zákaznických dat k trénování | Google Cloud se smluvně zavazuje, že zákaznická data nepoužije k trénování ani dolaďování AI/ML modelů bez předchozího svolení nebo pokynu zákazníka. | AWS uvádí, že obsah zákazníka nepoužívá k trénování modelů a nesdílí prompty ani odpovědi s poskytovateli modelů. |
| Požadované umístění | Umístění eu, evropské regionální API a pouze funkce s podporou at-rest DRZ a MLP v EU. | Konkrétní region v členském státě EU nebo ověřený EU geografický inference profil volaný z regionu v EU. |
| Čemu se vyhnout | Umístění global a funkcím, které mají pro EU v tabulce uvedeno, že rezidenci nebo MLP nepodporují. | Globálním inference profilům, neověřeným evropským zdrojovým regionům a závislým službám mimo schválené regiony. |
| Kdo odpovídá za nastavení | Cloud chrání svou službu. Zákazník odpovídá za volbu regionu, modelu, oprávnění, konektorů, logování a za data, která do systému posílá. |
Obě platformy mohou splnit rozumně navržený firemní scénář. Ani jedna však není automatická „GDPR krabička“. Rozhodující je konkrétní edice, region, model, zapnuté funkce a navazující architektura.
Jaké modely můžete v EU takto provozovat – není to jen Gemini a Titan
Tabulka výše srovnává dvě cloudové platformy. Neříká ale, že byste na nich směli použít jen modely od Googlu a Amazonu. Právě naopak. Obě platformy nabízejí desítky modelů od různých výrobců – a mnohé z nich podporují zpracování v evropských regionech se stejnou garancí, že se zákaznická data nepoužijí k trénování.
Klíčová otázka nezní „jakou značku modelu chci?“, ale „podporuje konkrétní model v konkrétním regionu EU požadovanou úroveň rezidence a zároveň garanci, že data neslouží k trénování?“
Následující přehled ukazuje, co je v době psaní článku (září 2026) dostupné. U každého modelu vždy ověřte aktuální regionální podporu v dokumentaci – nabídka se mění měsíc od měsíce.
Modely na Google Cloud (Gemini Enterprise + Vertex AI)
| Model | Výrobce | EU rezidence (umístění eu) | Poznámka |
|---|---|---|---|
| Gemini 2.0 Flash | ✅ Ano | Nativní model Google; ověřte podporu MLP pro EU u konkrétní verze | |
| Gemini 2.0 Pro | ✅ Ano | Výkonnější varianta pro složitější úlohy | |
| Gemini 1.5 Flash / Pro | ✅ Ano | Starší, ale stále dostupné a podporované | |
| Claude (Anthropic) | Anthropic | ⚠️ Přes Vertex AI, ověřte region | Claude 3.5 Sonnet, Claude 3 Opus a Haiku jsou na Vertex AI dostupné; regionální podporu EU ověřte v aktuální dokumentaci Vertex AI Model Garden |
| Llama 3.x | Meta | ⚠️ Přes Vertex AI Model Garden | Dostupné jako spravované endpointy nebo vlastní nasazení; EU podpora závisí na konkrétním modelu a regionu |
| Gemma | ✅ Přes Vertex AI | Otevřené modely vhodné pro vlastní jemné ladění | |
| Imagen | ⚠️ Omezeně v EU | Generování obrázků; dostupnost v EU se mění – ověřte před nasazením |
Modely na AWS (Amazon Bedrock)
Bedrock nabízí nejširší výběr modelů třetích stran – a právě to je jeho hlavní výhoda pro EU scénář. AWS provozuje kopie modelů ve vlastních účtech a obsah neposílá jejich výrobcům.
| Model | Výrobce | EU regiony (In-Region) | Poznámka |
|---|---|---|---|
| Claude 3.5 Sonnet | Anthropic | ✅ Frankfurt, Irsko, Paříž | Jeden z nejvýkonnějších modelů na trhu; dostupný přímo v EU regionech |
| Claude 3 Haiku | Anthropic | ✅ Frankfurt, Irsko | Rychlá a levnější varianta Claude pro rutinní úlohy |
| Claude 3 Opus | Anthropic | ⚠️ Ověřte v dokumentaci | Nejvýkonnější Claude; regionální dostupnost se mění |
| Llama 3.1 70B / 405B | Meta | ✅ Frankfurt, Irsko, Paříž | Otevřené modely; 405B vyžaduje geographic cross-region – ověřte cílové regiony |
| Llama 3.2 | Meta | ✅ Více EU regionů | Menší modely vhodné pro jednodušší úlohy a nižší náklady |
| Mistral Large | Mistral AI 🇪🇺 | ✅ Paříž | Evropský model od evropské firmy. Silná volba pro EU-first strategii |
| Mistral Small / Mixtral | Mistral AI 🇪🇺 | ✅ Více EU regionů | Efektivní evropské modely pro méně náročné úlohy |
| Command R / R+ | Cohere | ✅ Více EU regionů | Specializované na RAG (vyhledávání v dokumentech) a sumarizaci |
| Amazon Titan | AWS | ✅ Více EU regionů | Vlastní modely Amazonu; embedding, text, multimodální |
| Jurassic-2 | AI21 Labs | ⚠️ Ověřte v dokumentaci | Specializované na generování a porozumění textu |
| Stable Diffusion | Stability AI | ⚠️ Ověřte v dokumentaci | Generování obrázků; EU podpora se může lišit |
Modely na Microsoft Azure (Azure OpenAI Service)
Azure OpenAI Service je třetí relevantní cesta, pokud vaše firma používá Microsoft 365, Azure nebo potřebuje modely OpenAI s garancí EU rezidence. Není to „veřejné ChatGPT“. Je to podniková služba s vlastními podmínkami, regiony a smluvním závazkem, že data nejsou použita k trénování.
| Model | Výrobce | EU regiony | Poznámka |
|---|---|---|---|
| GPT-4o | OpenAI | ✅ West Europe, North Europe, France Central, Sweden Central | Nejnovější multimodální model OpenAI; dostupný s EU rezidencí přes Azure |
| GPT-4 | OpenAI | ✅ Více EU regionů | Starší, ale prověřený model pro náročné textové úlohy |
| GPT-3.5 Turbo | OpenAI | ✅ Více EU regionů | Lev nejlevnější varianta pro jednoduché úlohy |
| DALL·E | OpenAI | ✅ Sweden Central | Generování obrázků; omezenější regionální dostupnost |
Důležité: běžné ChatGPT (web nebo aplikace) a API od OpenAI přímo (
api.openai.com) není totéž co Azure OpenAI Service. Azure nabízí vlastní smluvní podmínky, EU datovou rezidenci a garanci, že data nejsou použita k trénování. Samotné OpenAI API tyto garance pro EU nemá ve stejném rozsahu.
Rychlé srovnání platforem podle modelů
| Co potřebujete | Google Cloud | AWS Bedrock | Azure OpenAI |
|---|---|---|---|
| Modely OpenAI (GPT-4o, GPT-4) | ❌ | ❌ | ✅ S EU rezidencí |
| Modely Anthropic (Claude) | ⚠️ Přes Vertex AI | ✅ Nejpřímější cesta | ❌ |
| Modely Meta (Llama) | ⚠️ Přes Model Garden | ✅ Široká podpora | ⚠️ Přes Azure AI Studio |
| Modely Google (Gemini) | ✅ Nativní | ❌ | ❌ |
| Evropské modely (Mistral) | ❌ | ✅ Paříž | ⚠️ Přes Azure AI Studio |
| Nejvíc modelů celkem | Desítky (Vertex AI) | Desítky (Bedrock) | Jednotky (Azure OpenAI) |
Praktické doporučení: pokud chcete Claude, jděte přes AWS Bedrock. Pokud chcete GPT-4o, jděte přes Azure OpenAI. Pokud chcete Gemini, jděte přes Google Cloud. Pokud chcete evropský model, Mistral na Bedrocku v Paříži je nejsilnější kombinace. A pokud potřebujete kombinaci – například Claude pro analýzu smluv a GPT-4o pro komunikaci se zákazníky – můžete použít více platforem současně. Důležité je, že u každé samostatně dodržíte pravidla rezidence a trénování.
Porovnání modelů: v čem je který lepší
Tabulka níže srovnává hlavní modely dostupné s EU rezidencí napříč skutečnými firemními potřebami. Nesrovnává laboratorní benchmarky, ale praktické vlastnosti, které ovlivní váš výběr pro konkrétní úlohu.
| Model | Logické uvažování | Práce s dlouhými texty | Čeština a další jazyky | Cena (relativní) | RAG / vyhledávání v dokumentech | Strukturovaný výstup (JSON, tabulky) |
|---|---|---|---|---|---|---|
| Claude 3.5 Sonnet | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ 200K tokenů | ⭐⭐⭐⭐⭐ Výborná | 💰💰💰 Vyšší střed | ⭐⭐⭐⭐⭐ Nejlepší pro dlouhé dokumenty | ⭐⭐⭐⭐⭐ Spolehlivý |
| Claude 3 Haiku | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ 200K tokenů | ⭐⭐⭐⭐⭐ Výborná | 💰 Nejlevnější z Claude | ⭐⭐⭐⭐⭐ Výborný pro rychlé dotazy | ⭐⭐⭐⭐⭐ Spolehlivý |
| Claude 3 Opus | ⭐⭐⭐⭐⭐ Nejsilnější | ⭐⭐⭐⭐⭐ 200K tokenů | ⭐⭐⭐⭐⭐ Výborná | 💰💰💰💰 Nejdražší | ⭐⭐⭐⭐⭐ Výborný | ⭐⭐⭐⭐⭐ Spolehlivý |
| GPT-4o | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ 128K tokenů | ⭐⭐⭐⭐ Velmi dobrá | 💰💰💰 Vyšší střed | ⭐⭐⭐⭐ Velmi dobrý | ⭐⭐⭐⭐⭐ Spolehlivý |
| GPT-4 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ 128K tokenů | ⭐⭐⭐⭐ Velmi dobrá | 💰💰💰💰 Nejdražší | ⭐⭐⭐⭐ Velmi dobrý | ⭐⭐⭐⭐⭐ Spolehlivý |
| GPT-3.5 Turbo | ⭐⭐⭐ | ⭐⭐⭐ 16K tokenů | ⭐⭐⭐ Dobrá | 💰 Nejlevnější | ⭐⭐⭐ Dostatečný | ⭐⭐⭐ Občas nespolehlivý |
| Gemini 2.0 Flash | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ 1M tokenů | ⭐⭐⭐⭐ Velmi dobrá | 💰💰 Nízký střed | ⭐⭐⭐⭐⭐ Výborný (Grounding) | ⭐⭐⭐⭐ Spolehlivý |
| Gemini 2.0 Pro | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ 1M tokenů | ⭐⭐⭐⭐ Velmi dobrá | 💰💰💰 Vyšší střed | ⭐⭐⭐⭐⭐ Výborný (Grounding) | ⭐⭐⭐⭐ Spolehlivý |
| Llama 3.1 70B | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ 128K tokenů | ⭐⭐⭐ Dostatečná | 💰💰 Nízký střed | ⭐⭐⭐⭐ Velmi dobrý | ⭐⭐⭐⭐ Spolehlivý |
| Llama 3.1 405B | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ 128K tokenů | ⭐⭐⭐ Dostatečná | 💰💰💰 Vyšší střed | ⭐⭐⭐⭐ Velmi dobrý | ⭐⭐⭐⭐ Spolehlivý |
| Mistral Large | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ 128K tokenů | ⭐⭐⭐⭐⭐ Výborná (evropské jazyky) | 💰💰💰 Vyšší střed | ⭐⭐⭐⭐ Velmi dobrý | ⭐⭐⭐⭐⭐ Spolehlivý |
| Command R+ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ 128K tokenů | ⭐⭐⭐⭐ Velmi dobrá | 💰💰 Nízký střed | ⭐⭐⭐⭐⭐ Specialista na RAG | ⭐⭐⭐⭐ Spolehlivý |
Hodnocení vychází z praktických zkušeností a veřejně dostupných srovnání k září 2026. Hvězdičky porovnávají modely mezi sebou, nikoliv absolutní kvalitu – i tříhvězdičkový model je dnes výkonnější než nejlepší modely před dvěma lety.
Jak číst tabulku podle úlohy
Analýza smluv a právních dokumentů
Potřebujete: přesné logické uvažování, práci s dlouhými texty, spolehlivý strukturovaný výstup. Vítěz: Claude 3.5 Sonnet na Bedrocku. Kombinace 200K kontextového okna, výborné češtiny a nejspolehlivějšího strukturovaného výstupu z něj dělá první volbu pro extrakci klauzulí, termínů a podmínek ze smluv. Alternativa: Claude 3 Opus pro nejsložitější případy, Gemini 2.0 Pro pokud už jste v Google Cloudu.
Zákaznická podpora a komunikace
Potřebujete: přirozený jazyk, češtinu, rychlost, přijatelnou cenu. Vítěz: Claude 3 Haiku na Bedrocku. Je nejrychlejší z prémiových modelů, píše přirozeně česky a stojí nejméně z rodiny Claude. Alternativa: GPT-4o na Azure pro zákazníky v Microsoft ekosystému, Mistral Large pro evropskou jazykovou přirozenost.
Vyhledávání ve firemních dokumentech (RAG)
Potřebujete: velké kontextové okno, přesnou citaci zdrojů, schopnost říct „to v dokumentech nemám“. Vítěz: Gemini 2.0 Flash/Pro na Google Cloud. Milion tokenů kontextu znamená, že do promptu vložíte stovky stran najednou. Vestavěný Grounding s ověřením zdrojů je unikátní funkce. Alternativa: Command R+ na Bedrocku (specialista na RAG), Claude 3.5 Sonnet (přesnější, ale menší okno).
Vícejazyčné zpracování (čeština, slovenština, němčina)
Potřebujete: přirozenou češtinu bez anglické struktury vět, porozumění místním reáliím. Vítěz: Claude 3.5 Sonnet nebo Mistral Large. Claude píše nejpřirozenější češtinu ze všech modelů. Mistral Large jako evropský model exceluje v evropských jazycích včetně češtiny. GPT-4o je těsně za nimi.
Kreativní psaní a marketing
Potřebujete: stylistickou pestrost, nápaditost, schopnost držet tón značky. Vítěz: GPT-4o na Azure. Modely OpenAI mají nejširší stylistický rozsah a nejlépe zvládají kreativní zadání s konkrétním tónem. Alternativa: Claude 3.5 Sonnet (přirozenější, ale méně stylově variabilní), Mistral Large (evropská alternativa).
Nízkorozpočtové nasazení
Potřebujete: nejnižší cenu za přijatelnou kvalitu. Vítěz: Llama 3.1 70B na Bedrocku nebo GPT-3.5 Turbo na Azure. Llama 3.1 70B nabízí solidní výkon za zlomek ceny Claude nebo GPT-4o. GPT-3.5 Turbo je ještě levnější, ale kvalitativně znatelně horší – hodí se na klasifikaci, extrakci klíčových slov a jednoduché dotazy, ne na analýzu smluv.
Maximální bezpečnost a compliance
Potřebujete: model od evropské firmy, inference v EU, minimum třetích stran v řetězci. Vítěz: Mistral Large na Bedrocku v Paříži. Evropská firma, model zpracovaný v Paříži, přes AWS jako důvěryhodného prostředníka. Nejkratší řetězec důvěry pro EU-first strategii.
Srovnání rodin modelů – jak přemýšlet při výběru
| Rodina | Silné stránky | Slabé stránky | Kdy ji vybrat |
|---|---|---|---|
| Claude (Anthropic) | Nejpřesnější logické uvažování; nejpřirozenější čeština; nejdelší kontextové okno (200K); nejspolehlivější strukturovaný výstup; výborná práce s dlouhými dokumenty | Méně kreativní než GPT-4o; nemá nativní multimodální vstup (obrázky přes API omezeně); pomalejší než Gemini Flash | Smlouvy, právní texty, analýza dokumentů, extrakce dat, technická dokumentace – všude, kde je přesnost důležitější než rychlost |
| GPT (OpenAI přes Azure) | Nejširší stylistický rozsah; nejlepší kreativní psaní; vynikající multimodální vstup (GPT-4o); nejsilnější ekosystém nástrojů a integrací | Čeština mírně horší než Claude; kontextové okno 128K (vs 200K u Claude); Azure OpenAI Service má méně modelů než Bedrock | Marketingové texty, kreativní úlohy, chatboti s multimediálním vstupem, firmy v Microsoft ekosystému |
| Gemini (Google) | Největší kontextové okno (1M tokenů); nejlepší integrace s Google ekosystémem; unikátní Grounding (ověřování faktů z webu); velmi rychlý (Flash) | Čeština a evropské jazyky mírně horší než Claude; méně přirozený styl psaní; menší výběr modelů třetích stran na Vertex AI | Vyhledávání ve velkých sadách dokumentů, firmy používající Google Workspace, sumarizace stovek stran, fakta vyžadující ověření |
| Llama (Meta) | Otevřený model – žádný vendor lock-in; nejnižší cena za solidní výkon; možnost vlastního doladění; transparentní architektura | Horší čeština a evropské jazyky; slabší kreativní psaní; méně přesné logické uvažování než Claude nebo GPT-4o; menší kontextové okno | Klasifikace, extrakce klíčových slov, jednoduché dotazy, scénáře kde cena rozhoduje a kvalita češtiny není kritická |
| Mistral (Mistral AI 🇪🇺) | Evropská firma – nejkratší řetězec důvěry pro EU; výborné evropské jazyky včetně češtiny; silné logické uvažování (Large); otevřené váhy u menších modelů | Menší výběr modelů (Large, Small, Mixtral); méně rozšířený ekosystém; menší kontextové okno než Claude nebo Gemini; omezená multimodálnost | EU-first strategie, evropské jazyky, organizace s požadavkem na evropského dodavatele AI, kombinace s Claude pro maximální přesnost |
| Command R (Cohere) | Specialista na RAG; výborná sumarizace; solidní vícejazyčnost; efektivní poměr cena/výkon | Horší kreativní psaní; menší flexibilita mimo RAG scénáře; méně známý ekosystém | Vyhledávání v dokumentech s přesnou citací zdrojů, sumarizace reportů, firemní znalostní báze |
Praktický příklad: jak vybrat model pro konkrétní firmu
Představte si středně velkou českou firmu, která potřebuje:
- Analyzovat smlouvy – extrahovat termíny, smluvní pokuty, výpovědní lhůty.
- Odpovídat na zákaznické dotazy – česky, přirozeně, s odkazem na interní předpisy.
- Psát marketingové texty – produktové popisy, newslettery.
Firma používá AWS pro infrastrukturu a má striktní požadavek na EU rezidenci.
Doporučené řešení:
- Úloha 1 (smlouvy): Claude 3.5 Sonnet na Bedrocku ve Frankfurtu. Přesný, spolehlivý, výborná čeština, 200K kontext.
- Úloha 2 (podpora): Claude 3 Haiku na Bedrocku ve Frankfurtu. Rychlý, levnější, stejně kvalitní čeština, dostačující pro rutinní dotazy.
- Úloha 3 (marketing): GPT-4o přes Azure OpenAI ve West Europe. Nejlepší kreativní psaní, nejširší stylistický rozsah.
Ano, používají se dvě platformy. Ale u každé samostatně je dodržena EU rezidence, zákaz trénování a technické hranice popsané v tomto článku. To je zcela legitimní a v praxi běžné.
Tři vrstvy, které musíte posoudit odděleně
1. Data se nepoužijí k trénování sdíleného modelu
Do této vrstvy patří otázka, zda poskytovatel použije váš dokument, prompt nebo odpověď ke zlepšení základního modelu pro ostatní zákazníky. U placených podnikových služeb Google Cloud a Amazon Bedrock je výchozí odpověď ne, pokud k tomu sami nedáte pokyn.
To neznamená, že model dokument vůbec nezpracuje. Bez zpracování by nemohl odpovědět. Znamená to, že se obsah po vyřízení požadavku nestane trénovacím materiálem pro příští verzi sdíleného modelu.
Jiná situace nastává, když si sami objednáte doladění nebo vytvoření vlastního modelu. V takovém případě jsou vybraná data záměrně použita pro váš privátní model. Nejde však o automatické učení veřejného základního modelu.
2. Obsah se ukládá a zpracovává v EU
Zde sledujeme dva samostatné pojmy:
- data at rest, tedy dokumenty, indexy, embeddingy, historie konverzací a další uložené kopie;
- machine learning processing, tedy místo, kde model skutečně provede výpočet nad promptem a vytvoří odpověď.
Uložení v EU nestačí, pokud je inference směrována do globálního endpointu. Stejně tak evropská inference nepomůže, když aplikace ukládá historii chatu do databáze v USA.
3. Logy, podpora a provozní metadata
„Bez trénování“ neznamená „bez jakéhokoli záznamu“. Poskytovatelé musí službu zabezpečit, účtovat a řešit zneužití. Některé modely nebo funkce proto mohou dočasně uchovávat prompty a odpovědi pro detekci zneužití. Vedle toho vznikají provozní údaje, například čas požadavku, účet, počet tokenů, chyba nebo použitý region.
Do názvů projektů, zdrojů, štítků a tagů proto nikdy nevkládejte osobní nebo důvěrné údaje. Tyto hodnoty se běžně objevují v diagnostických a fakturačních systémech, i když samotný obsah promptu chrání přísnější pravidla.
Varianta A: Google Cloud a Gemini Enterprise Agent Platform
Co Google garantuje u trénování
Google Cloud ve svých podmínkách uvádí, že zákaznická data nepoužije k trénování ani dolaďování AI/ML modelů bez předchozího svolení nebo pokynu zákazníka. U Gemini Enterprise to zahrnuje prompty, výstupy a data použitá pro vaše vlastní nastavení.
Tato garance se vztahuje k podnikové cloudové službě a jejím smluvním podmínkám. Nelze ji automaticky přenést na osobní spotřebitelské účty, experimentální edice nebo jiný produkt pouze proto, že má v názvu Gemini. Před nákupem proto ověřte přesnou edici a smlouvu.
Jak se nastavuje rezidence v EU
Gemini Enterprise podporuje umístění eu. Google u základních funkcí uvádí podporu evropské datové rezidence pro uložená data a podporu strojového zpracování v EU. Aby tato garance platila, musí být aplikace a datové úložiště vytvořeny v umístění eu a API musí používat evropskou cestu.
V praxi se evropský endpoint pozná například podle této adresy:
https://eu-discoveryengine.googleapis.com/v1/projects/PROJECT_ID/locations/eu/...
Toto není příkaz do Terminálu. Je to ukázka adresy API, kterou má vývojář nebo integrátor použít v konfiguraci aplikace. Text PROJECT_ID se nahrazuje identifikátorem vašeho projektu.
Globální varianta obsahuje v cestě global nebo používá globální endpoint bez evropské předpony. Pro scénář, ve kterém obsah nesmí opustit EU, ji nepoužívejte.
Kde Google variantu nastavíte
Kde: Google Cloud Console v běžném webovém prohlížeči.
- Založte samostatný Google Cloud projekt pouze pro schválené AI zpracování.
- Při vytváření Gemini Enterprise aplikace zvolte jako umístění EU (multiple regions in the European Union), technicky
eu. - Vytvořte datové úložiště ve stejném umístění
eu. Zdrojové dokumenty, index a aplikace nemají být rozděleny mezi EU a global. - Povolte pouze modely a funkce, které mají v aktuální tabulce Google uvedenu podporu at-rest DRZ i MLP pro EU.
- Pro integrace používejte evropské regionální endpointy. Globální endpointy zakažte v šablonách a kontrolách nasazení.
- Zapněte auditní logy, omezte administrátory a pro běžné uživatele použijte skupiny místo jednotlivých širokých oprávnění.
Co zkontrolovat na obrazovce před potvrzením: u umístění musí být uvedeno
eu, neglobal. Pokud funkce zobrazí upozornění, že kvůli její dostupnosti bude provoz směrován globálně, funkci nezapínejte.
Omezení, která se u Googlu nesmí přehlédnout
Regionální nabídka nemá vždy všechny novinky, které nabízí globální provoz. Dokumentace Gemini Enterprise uvádí omezení po jednotlivých modelech a funkcích. Některý model může podporovat evropskou rezidenci, jiný může být v EU nedostupný a další může být dostupný pouze globálně.
Zvláštní pozornost věnujte těmto položkám:
- Grounding with Google Search je globální funkce a dočasně loguje některá zákaznická data. Pro přísný EU scénář ho nepoužívejte.
- Generování videa může být dostupné pouze v globálním umístění.
- Konkrétní verze modelů mohou mít jiné podmínky. Nelze schválit značku Gemini obecně a následně libovolně měnit model.
- Code execution v Agent Engine může mít pro EU omezení datové rezidence. Pokud ho nepotřebujete, nezapínejte ho.
- Konektory mohou číst data z Google Workspace, Microsoft 365, ServiceNow nebo dalších systémů. Jejich vlastní uložení, přenosy a oprávnění musíte posoudit odděleně.
Retence a bezpečnostní kontroly u Googlu
Google nabízí informace k režimu zero data retention, ale nula není univerzální vlastnost každé kombinace modelu a funkce. Při podezření na zneužití může systém uložit prompt pro vyšetření porušení pravidel. U funkcí označených jako Advanced AI mohou být prompty a odpovědi uchovány až 30 dní pro bezpečnostní kontrolu. Google uvádí, že ani tato data nepoužije k trénování a že bezpečnostní záznamy dodržují zvolenou datovou rezidenci. U některých pokročilých funkcí nemusí být možné logování vypnout.
Proto do dokumentace řešení napište dvě věty, ne jednu:
- zákaznická data nejsou bez našeho pokynu použita k trénování sdílených modelů;
- u schválených funkcí může existovat omezená bezpečnostní retence podle aktuálních podmínek služby.
Varianta B: AWS a Amazon Bedrock
Co AWS garantuje u trénování
AWS uvádí, že Amazon Bedrock nepoužívá obsah zákazníka k trénování základních modelů. Modeloví dodavatelé, například Anthropic, Meta nebo Cohere, nemají přístup k promptům a odpovědím zákazníka v Bedrocku. AWS provozuje kopie modelů ve vlastních oddělených účtech a obsah neposílá zpět jejich autorům.
To je jedna z praktických výhod Bedrocku. Firma může používat model jiného výrobce, aniž by mu přímo odesílala své dokumenty. Smluvním a technickým prostředníkem zůstává AWS.
Tři způsoby inference v Bedrocku
Bedrock nabízí tři odlišné způsoby směrování. Pro rezidenci dat je jejich rozdíl zásadní.
| Režim | Kde může proběhnout zpracování | Vhodnost pro požadavek „pouze EU“ |
|---|---|---|
| In-Region | Pouze ve zvoleném AWS regionu. | Nejjednodušší k prokázání, pokud vyberete region v členském státě EU a model v něm podporuje přímou inferenci. |
| Geographic Cross-Region | V jednom z cílových regionů uvedených v konkrétním geografickém profilu. | Může být vhodný, ale musíte ověřit zdrojový region a úplný seznam cílových regionů konkrétního modelu. |
| Global Cross-Region | V podporovaných komerčních regionech po světě. | Nevhodný. Nabízí vyšší kapacitu nebo nižší cenu výměnou za ztrátu geografického omezení. |
Pokud potřebujete co nejsrozumitelnější kontrolu, začněte režimem In-Region například ve Frankfurtu, Paříži, Irsku, Miláně, Stockholmu nebo Španělsku. Vyberte pouze region, ve kterém konkrétní model podporuje přímé regionální zpracování.
Jestli model vyžaduje Geographic Cross-Region inference, použijte profil s předponou eu., ale tím kontrola nekončí. Otevřete dokumentaci konkrétního modelu a zkontrolujte tabulku Source Region / Destination Regions.
Důležitá nuance: profil s názvem EU může při volání z Londýna zahrnout Londýn a při volání z Curychu zahrnout Curych. Pro přísnou hranici Evropské unie proto volejte z regionu ležícího v členském státě EU a ověřte, že všechny uvedené cílové regiony jsou také v členských státech EU.
Kde AWS variantu nastavíte
Kde: AWS Management Console v běžném webovém prohlížeči.
- V pravém horním rohu konzole zvolte schválený region v EU, například Europe (Frankfurt) s kódem
eu-central-1. - Otevřete službu Amazon Bedrock a v katalogu modelů ověřte regionální dostupnost vybraného modelu.
- Pokud je dostupné In-Region zpracování, použijte přímé ID modelu bez předpony
global.. - Pokud potřebujete geografický profil, použijte pouze profil
eu.a před schválením zkontrolujte jeho pevný seznam cílových regionů. - V AWS Organizations vytvořte Service Control Policy, která zakáže globální inference profily a nepovolené regiony. Tento krok má provést správce AWS, ne běžný uživatel Bedrocku.
- Omezte oprávnění IAM na schválené modely, inference profily a operace. Uživatel nemá mít možnost omezení obejít výběrem jiného profilu.
- Zdrojové dokumenty, znalostní bázi, vektorové úložiště, klíče KMS, aplikační logy a zálohy vytvořte pouze ve schválených regionech EU.
Provozní tým by měl v CloudTrail kontrolovat údaj additionalEventData.inferenceRegion. Ten ukazuje region, ve kterém byl požadavek skutečně zpracován při cross-region inference. Kontrola logu nenahrazuje preventivní omezení, ale pomůže odhalit chybu a doložit provoz.
Co se u AWS často přehlédne
- Globální profil může být levnější. Nižší cena nesmí přimět vývojáře, aby bez schválení změnil
eu.naglobal.. - S3 není jediná ukládací služba. Knowledge Bases mohou používat OpenSearch Serverless, Aurora nebo jiné vektorové úložiště. Každá součást potřebuje vlastní regionální kontrolu.
- Guardrails jsou další zpracování. Ověřte regionální profil i u nich, nejen u hlavního modelu.
- CloudWatch a aplikační logy mohou obsahovat prompty. Nelogujte celé tělo požadavku, pokud ho skutečně nepotřebujete. Nastavte dobu uchování a maskování.
- Názvy a tagy se mohou objevit v diagnostice a fakturaci. Nepoužívejte v nich jména zákazníků, rodná čísla ani obsah případu.
- Odkaz na externí nástroj opouští hranici Bedrocku. Agent, který volá internetové API, může citlivá data odeslat mimo AWS a mimo EU, i když samotný model běží správně.
Retence a detekce zneužití u AWS
AWS obecně uvádí, že Bedrock prompty a odpovědi neukládá ani neloguje a nepoužívá je k trénování. Dokumentace však zároveň popisuje výjimky spojené s detekcí zneužití u některých modelů a funkcí. Při cross-region inference může být bezpečnostní kopie promptu nebo výsledku uložena v cílovém regionu.
Proto u každého schváleného modelu ověřte stránku Amazon Bedrock abuse detection. Do architektonického rozhodnutí zapište, zda model ukládá obsah pro detekci zneužití, kde a po jakou dobu. Pokud je požadována absolutní nulová retence, nestačí obecná produktová stránka.
Bezpečná referenční architektura
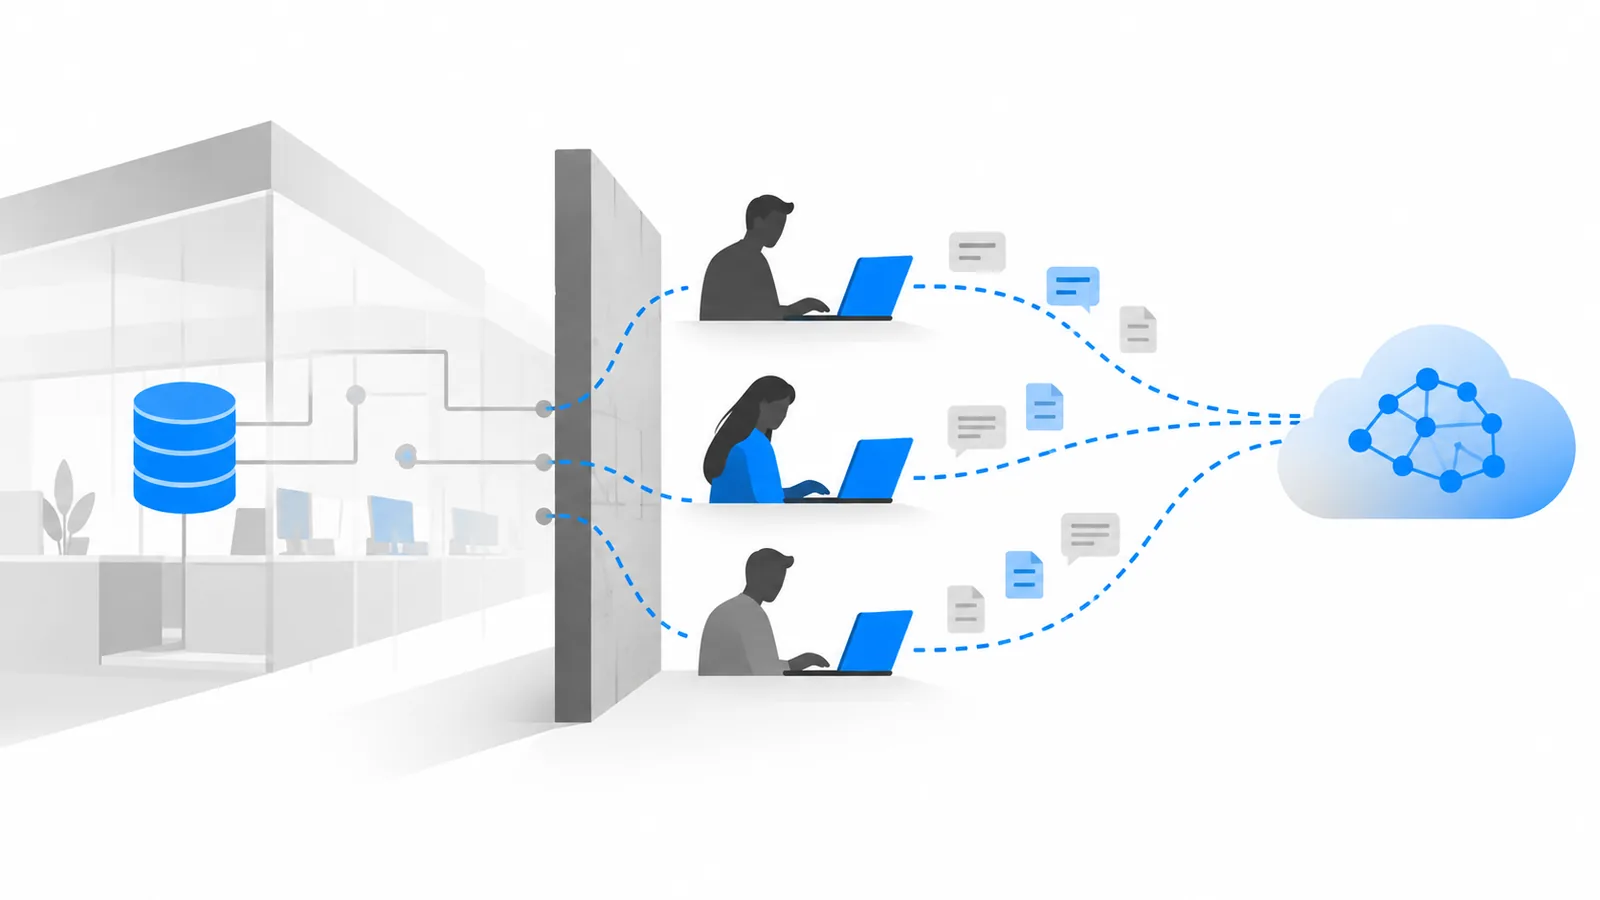
Nejbezpečnější první scénář není obecný firemní chatbot, který vidí všechno. Je to úzce vymezená aplikace, která čte jednu schválenou sadu dokumentů a provádí jednu popsanou činnost, například připraví návrh odpovědi na reklamaci.
Uživatel v EU
    ↓
Firemní aplikace a přihlášení v EU
    ↓
Kontrola a případné odstranění citlivých údajů
    ↓
Dokumentové a vektorové úložiště v EU
    ↓
Gemini Enterprise v umístění eu
nebo Amazon Bedrock v ověřeném EU režimu
    ↓
Výsledek uložený v EU
    ↓
Auditní záznam bez celého obsahu promptu
Za hranicí schématu nesmí zůstat zapomenutý analytický nástroj, globální vyhledávání, plugin, systém pro hlášení chyb ani neřízený export. Každá šipka představuje přenos, který je třeba znát a povolit.
Minimální technická opatření
- Samostatný cloudový projekt nebo účet. Pilot nemíchejte s osobními experimenty ani s jinými zákazníky.
- Pevně zvolený region. Region nesmí být jen doporučení v dokumentaci. Vynucujte ho politikou organizace a nasazovací šablonou.
- Nejméně nutná oprávnění. Uživatel smí číst pouze dokumenty potřebné pro svůj úkol. AI nesmí obejít oprávnění zdrojového systému.
- Šifrování při přenosu a uložení. U citlivějších scénářů zvažte zákaznicky spravované klíče a oddělené správce klíčů.
- Soukromé síťové připojení. Kde to architektura dovolí, používejte privátní endpointy a neposílejte provoz přes veřejný internet.
- Minimalizace dat. Do modelu neposílejte celý spis, pokud stačí jedna stránka. Identifikátory nahraďte pseudonymy, pokud jejich skutečná hodnota není pro výsledek nutná.
- Řízené logování. Zaznamenejte kdo, kdy, jaký schválený proces a model použil. Celý prompt ukládejte pouze s jasným důvodem a omezenou dobou uchování.
- Kontrola konektorů a nástrojů. Každý nástroj, který agent volá, je další zpracovatel a další možná cesta úniku.
- Lidské potvrzení. Návrh smlouvy, rozhodnutí o zákazníkovi nebo odeslání zprávy musí zkontrolovat oprávněná osoba.
Praktický postup pro první firemní pilot
Krok 1: Popište data dříve, než vyberete model
Kde: interní dokument schvalovaný vlastníkem procesu, IT a člověkem odpovědným za ochranu údajů.
Napište, jaké dokumenty bude řešení číst, zda obsahují osobní údaje, obchodní tajemství nebo zvláštní kategorie údajů, kdo smí vidět výsledek a jak dlouho ho potřebujete uchovat. Pokud tuto tabulku neumíte vyplnit, není ještě co bezpečně nasazovat.
| Otázka | Příklad odpovědi |
|---|---|
| Účel zpracování | Připravit návrh odpovědi na běžnou reklamaci |
| Vstupní data | Text reklamace, objednaný produkt a interní reklamační pravidla |
| Data, která model nepotřebuje | Rodné číslo, platební údaje, heslo zákazníka |
| Výsledek | Návrh textu, který před odesláním schválí pracovník podpory |
| Doba uchování | Podle existujícího reklamačního spisu, ne samostatně navždy v AI aplikaci |
Krok 2: Vyberte jeden schválený model a funkce
Kde: produktová dokumentace Google Cloud nebo AWS a interní architektonický záznam.
Neschvalujte „Gemini“ nebo „Claude“ obecně. Zapište přesný název a verzi modelu, region, endpoint, způsob inference a povolené doplňkové funkce. Uložte odkaz na dokumentaci platnou v den schválení. Při změně verze modelu kontrolu zopakujte.
Krok 3: Vynuťte hranice technicky
Kde: administrace cloudové organizace. Tento krok provádí cloudový administrátor.
Na Google Cloud zakažte použití globálních cest v nasazovací konfiguraci a povolte jen zdroje v eu. Podle citlivosti využijte organizační politiky, VPC Service Controls, skupinová oprávnění a případně zákaznicky spravované šifrovací klíče.
Na AWS omezte Bedrock pomocí IAM a Service Control Policies. Zakažte globální inference profily, nepovolené regiony a vytváření závislých úložišť mimo EU. Kód aplikace nesmí mít oprávnění tuto politiku měnit.
Krok 4: Otestujte, co se stane s dokumentem
Kde: oddělené testovací prostředí bez skutečných citlivých údajů.
Vložte syntetický dokument s jasně rozpoznatelným testovacím řetězcem. Ověřte, kde vznikl zdrojový soubor, index, embedding, výsledek, aplikační log a záloha. Zkontrolujte skutečný inference region a zkuste, zda lze zvolit zakázaný globální model. Správně nastavené prostředí má takový pokus odmítnout.
Krok 5: Spusťte omezený provoz a pravidelně ho kontrolujte
Začněte s několika uživateli a dokumenty nízké citlivosti. Sledujte změny modelu, regionální dostupnosti, funkcí a podmínek. Kontrolu opakujte alespoň při každé významné změně služby, konektoru nebo architektury.
Co nestačí
- „Máme podepsané NDA.“ NDA samo neurčuje region zpracování ani technicky nebrání odeslání dat jinam.
- „Poskytovatel je v souladu s GDPR.“ Soulad služby nepokrývá automaticky váš účel, vstupní data, oprávnění a dobu uchování.
- „Vybrali jsme Frankfurt.“ Hlavní aplikace může být ve Frankfurtu, ale model, vyhledávání, záloha nebo log mohou používat jinou lokaci.
- „Model se na datech netrénuje.“ Data mohou být stále dočasně zpracována nebo uchována pro bezpečnost, podporu či vámi zapnuté logování.
- „Data jsou anonymní.“ Odstranění jména nestačí, pokud lze člověka určit z čísla případu, adresy, kombinace údajů nebo připojené databáze.
- „Je to jen pilot.“ Pilot se skutečnými zákaznickými daty je stále zpracování skutečných zákaznických dat.
Kontrolní seznam před spuštěním
Nasazení nepovažujte za připravené, dokud u každého bodu nemáte konkrétní odpověď a vlastníka.
- Máme přesně popsaný účel a kategorie dat?
- Používáme placenou podnikovou službu pod firemní smlouvou?
- Potvrzuje smlouva, že zákaznická data nebudou bez našeho pokynu použita k trénování?
- Známe přesný model, verzi, region a endpoint?
- Podporuje daná kombinace ukládání i strojové zpracování v EU?
- Ověřili jsme všechny cílové regiony inference profilu?
- Zakázali jsme globální endpointy a profily technickou politikou?
- Jsou dokumenty, indexy, embeddingy, logy a zálohy v EU?
- Známe pravidla bezpečnostní retence pro vybraný model?
- Neobsahují názvy zdrojů a tagy citlivé údaje?
- Má každý konektor a externí nástroj vlastní posouzení?
- Dokážeme doložit, kdo službu použil a ve kterém regionu požadavek proběhl?
- Existuje postup pro incident, výmaz a odebrání přístupu?
- Schválil řešení vlastník procesu, bezpečnost a osoba odpovědná za ochranu dat?
Jak se rozhodnout mezi Google Cloud a AWS
Pokud firma už používá Google Workspace, BigQuery a řízení identit v Google Cloud, může být Gemini Enterprise přirozenější. Nabízí hotové podnikové vyhledávání, konektory a agentní prostředí. Přísný EU provoz ale může omezit výběr nejnovějších modelů a globálních funkcí.
Pokud firma už provozuje data a aplikace na AWS, Bedrock umožní využít více rodin modelů přes jednu cloudovou službu. Nabízí jasné rozlišení mezi zpracováním v jednom regionu, geografickým profilem a globálním profilem. Větší výběr však znamená větší odpovědnost za správnou kombinaci modelu, regionu a inference profilu.
Nejlepší platforma není ta s nejdelším seznamem funkcí. Je to ta, u které dokážete pro svůj konkrétní proces srozumitelně doložit:
- jaká data vstupují;
- kdo k nim má přístup;
- kde se ukládají;
- kde se zpracují;
- jak dlouho zůstanou;
- že nejsou použita k trénování sdíleného modelu;
- jak zabráníte změně na neschválenou globální funkci.
Závěr
Firemní data lze pomocí generativní AI zpracovávat tak, aby nebyla použita k trénování sdíleného modelu a aby jejich obsah zůstal v Evropské unii. Vyžaduje to ale víc než správně formulovaný prompt.
U Google Cloud znamená bezpečný základ placenou podnikovou edici Gemini Enterprise, umístění eu, evropské endpointy a pouze modely a funkce s výslovnou podporou evropské datové rezidence i strojového zpracování. U AWS znamená bezpečný základ Amazon Bedrock ve schváleném regionu EU, přímou regionální inferenci nebo prověřený eu. profil, zákaz globálních profilů a regionální kontrolu všech navazujících služeb. U Microsoft Azure znamená bezpečný základ Azure OpenAI Service v EU regionu s potvrzenou datovou rezidencí.
A jaké modely si můžete vybrat? Zdaleka nejde jen o Gemini a Amazon Titan. Na Bedrocku v EU regionech běží Claude (Anthropic), Llama (Meta), Mistral (evropská firma), Command R (Cohere) a další. Na Google Cloud Vertex AI běží vedle Gemini také Claude a Llama. Na Azure běží GPT-4o a GPT-4 od OpenAI. Každá platforma má jinou sadu modelů a vy si vyberete tu, která odpovídá vašim potřebám.
Transparentní odpověď proto nezní „ano, naše AI je bezpečná“. Zní: tato konkrétní data zpracovává tato verze modelu, přes tento endpoint, v těchto regionech, s touto dobou uchování a bez použití ke trénování sdíleného modelu.
Pokud potřebujete navrhnout bezpečný AI pilot nad firemními daty, ozvěte se mi. Pomohu vybrat vhodný proces, porovnat Google Cloud a AWS, navrhnout datové hranice a připravit kontrolní podklady pro IT, bezpečnost i vedení firmy.
Časté otázky
Používá Google Gemini Enterprise naše prompty k trénování?
U placené podnikové služby Google Cloud platí závazek, že Google nepoužije zákaznická data k trénování ani dolaďování AI/ML modelů bez předchozího svolení nebo pokynu zákazníka. Je však nutné ověřit přesnou edici. Spotřebitelský produkt nebo experimentální bezplatná nabídka může mít jiné podmínky.
Dostane se poskytovatel modelu k datům v Amazon Bedrock?
AWS uvádí, že poskytovatelé základních modelů nemají přístup k zákaznickým promptům a odpovědím z Bedrocku. Model je provozován v účtech spravovaných službou AWS a obsah se neposílá jeho autorovi k trénování.
Znamená „EU region“, že data určitě neopustí EU?
Ne bez další kontroly. U Googlu musí být aplikace, data store, endpoint, model i funkce kompatibilní s umístěním eu. U AWS je potřeba zkontrolovat zdrojový i všechny cílové regiony konkrétního inference profilu. Londýn a Curych jsou evropské AWS regiony, ale neleží v Evropské unii.
Je lepší jeden region, nebo EU cross-region?
Jeden region se snáze vysvětluje a kontroluje. Cross-region profil může nabídnout vyšší kapacitu a dostupnost, ale vyžaduje kontrolu všech cílových regionů. Pokud regulatorní nebo smluvní požadavek říká „jen jeden stát“ nebo „jen jeden region“, geografický EU profil nestačí.
Znamená zákaz trénování nulovou retenci?
Ne. Obsah může být dočasně uchován pro detekci zneužití nebo proto, že jste zapnuli aplikační logování. Zákaz trénování řeší účel použití dat, nikoli automaticky dobu jejich uchování.
Stačí toto nastavení pro GDPR?
Ne. Je to důležitá technická část, nikoli celé posouzení. Musíte řešit také účel a právní titul, transparentnost vůči lidem, minimalizaci, dobu uchování, práva subjektů údajů, smluvní role a podle rizika také DPIA.
O autorovi
Jan Krásenský je nezávislý IT konzultant a externí CTO pro střední firmy v Praze a Středočeském kraji, online po celé ČR. V IT působí od roku 2011 – jako vývojář, solution architekt, projektový manažer a ředitel. Pomáhá vybírat informační systémy, digitalizovat procesy a řídit IT projekty, vždy na straně klienta a bez provizí od dodavatelů.
Více o mně